MCP и CLI
Примечание: MCP и CLI (примеры - kubectl, psql, gh) в основном нужны для двух вещей:
- Чтобы модели не нужно было заново придумывать, как использовать тот или иной внешний источник. Вся внутренняя логика уже описана внутри MCP/CLI, агенту остаётся вызвать нужный инструмент или команду
- Чтобы ключи и пароли не попадали в контекст агента и не улетали в облака, ведь MCP и CLI заранее авторизуются в нужной системе (или хранят внутри у себя пароли)
Многие сейчас предпочитают CLI, так как он не тратит контекст и не нужно ничего настраивать. Но нужно обязательно убедиться, что через CLI агент не получит лишних ненужных доступов.
Описания инструментов MCP сейчас почти не занимают контекст: Claude Code по умолчанию подгружает их только тогда, когда они нужны (Tool Search). Но лишние серверы всё равно лучше не подключать - ради безопасности и чтобы агент не путался в похожих инструментах.
Не используйте непроверенные MCP-серверы, особенно ноунеймовые с маленьким количеством звёзд.
Можно запрещать MCP использовать определённые инструменты:
{
  "permissions": {
    "deny": [
      "mcp__postgresql-mcp-cloud-statistics__pg_manage_users",
      "mcp__postgresql-mcp-cloud-statistics__pg_execute_mutation"
    ]
  }
}
Можно делать ещё более хитрые штуки, например, блокировать тул выполнения запроса, если в его теле есть слова DROP или DELETE. Это делается с помощью хуков:
{
    "hooks": {
      "PreToolUse": [
        {
          "matcher": "mcp__postgresql-mcp-cloud-statistics__.*",
          "hooks": [
            {
              "type": "command",
              "command": "python3 /path/to/check_pg_args.py"
            }
          ]
        }
      ]
    }
  }
В питоновском скрипте пишете любые проверки, которые вам нужны, например:
import json
import re
import sys

# Tools that are always safe (read-only by design)
ALWAYS_ALLOW = {
    "pg_analyze_database",
    "pg_debug_database",
    "pg_get_setup_instructions",
    "pg_monitor_database",
}

# Tools that are always blocked (mutations, schema changes, user management)
ALWAYS_BLOCK = {
    "pg_execute_mutation",
    "pg_copy_between_databases",
    "pg_import_table_data",
    "pg_manage_comments",
    "pg_manage_constraints",
    "pg_manage_functions",
    "pg_manage_indexes",
    "pg_manage_rls",
    "pg_manage_schema",
    "pg_manage_triggers",
    "pg_manage_users",
}

# pg_manage_query: allowed operations
ALLOWED_QUERY_OPS = {"explain", "get_slow_queries", "get_stats"}
BLOCKED_QUERY_OPS = {"reset_stats"}

# SQL patterns that indicate mutation (for pg_execute_query, pg_execute_sql, pg_export_table_data)
DANGEROUS_SQL = re.compile(
    r"\b(INSERT|UPDATE|DELETE|DROP|ALTER|CREATE|TRUNCATE|GRANT|REVOKE|"
    r"REPLACE|MERGE|UPSERT|COPY\s+.+\s+FROM|VACUUM\s+FULL|REINDEX)\b",
    re.IGNORECASE,
)


def deny(reason: str):
    print(json.dumps({
        "hookSpecificOutput": {
            "hookEventName": "PreToolUse",
            "permissionDecision": "deny",
            "permissionDecisionReason": reason,
        }
    }))
    sys.exit(0)


def allow():
    sys.exit(0)


def get_tool_short_name(tool_name: str) -> str:
    """mcp__postgresql-mcp-cloud-statistics__pg_manage_users -> pg_manage_users"""
    parts = tool_name.split("__")
    return parts[-1] if parts else tool_name


def extract_sql(tool_input: dict) -> str:
    """Pull SQL from whichever field the tool uses."""
    for field in ("query", "sql", "statement"):
        if field in tool_input:
            return tool_input[field]
    return ""


def main():
    data = json.load(sys.stdin)
    tool_name = data.get("tool_name", "")
    tool_input = data.get("tool_input", {})
    short_name = get_tool_short_name(tool_name)

    # 1. Always safe
    if short_name in ALWAYS_ALLOW:
        allow()

    # 2. Always blocked
    if short_name in ALWAYS_BLOCK:
        deny(f"Blocked: {short_name} is not allowed in read-only mode")

    # 3. pg_manage_query - check operation
    if short_name == "pg_manage_query":
        op = tool_input.get("operation", "")
        if op in BLOCKED_QUERY_OPS:
            deny(f"Blocked: pg_manage_query operation '{op}' is not allowed")
        if op in ALLOWED_QUERY_OPS:
            if op == "explain":
                sql = extract_sql(tool_input)
                if DANGEROUS_SQL.search(sql):
                    deny(f"Blocked: EXPLAIN on a mutation query is not allowed")
            allow()
        deny(f"Blocked: unknown pg_manage_query operation '{op}'")

    # 4. pg_execute_query / pg_execute_sql / pg_export_table_data - check SQL
    if short_name in ("pg_execute_query", "pg_execute_sql", "pg_export_table_data"):
        sql = extract_sql(tool_input)
        if not sql.strip():
            deny(f"Blocked: empty SQL in {short_name}")
        if DANGEROUS_SQL.search(sql):
            deny(f"Blocked: mutation detected in {short_name}: {sql[:80]}...")
        allow()

    # 5. Unknown tool - block by default (whitelist approach)
    deny(f"Blocked: unknown PostgreSQL tool '{short_name}'")

if __name__ == "__main__":
    main()
Регулярка ловит не всё - например, SELECT pg_terminate_backend(...) пройдёт как обычный запрос. Так что такой хук - это дополнительная страховка, а не замена read-only пользователя.
Но главное правило в любом случае остаётся таким - не давайте Claude Code доступ к CLI или MCP, у которых есть доступы, которые могут похерить что-то важное. Скажем, если вы включаете MCP к БД статистики, то обязательно используйте только read-only пользователя.
Общий MCP-реджистри
Существует проект mcp-gateway-registry, который позволяет централизованно управлять MCP-серверами в организации. Мы уже используем его у себя (естественно, довольно сильно переписва под себя).
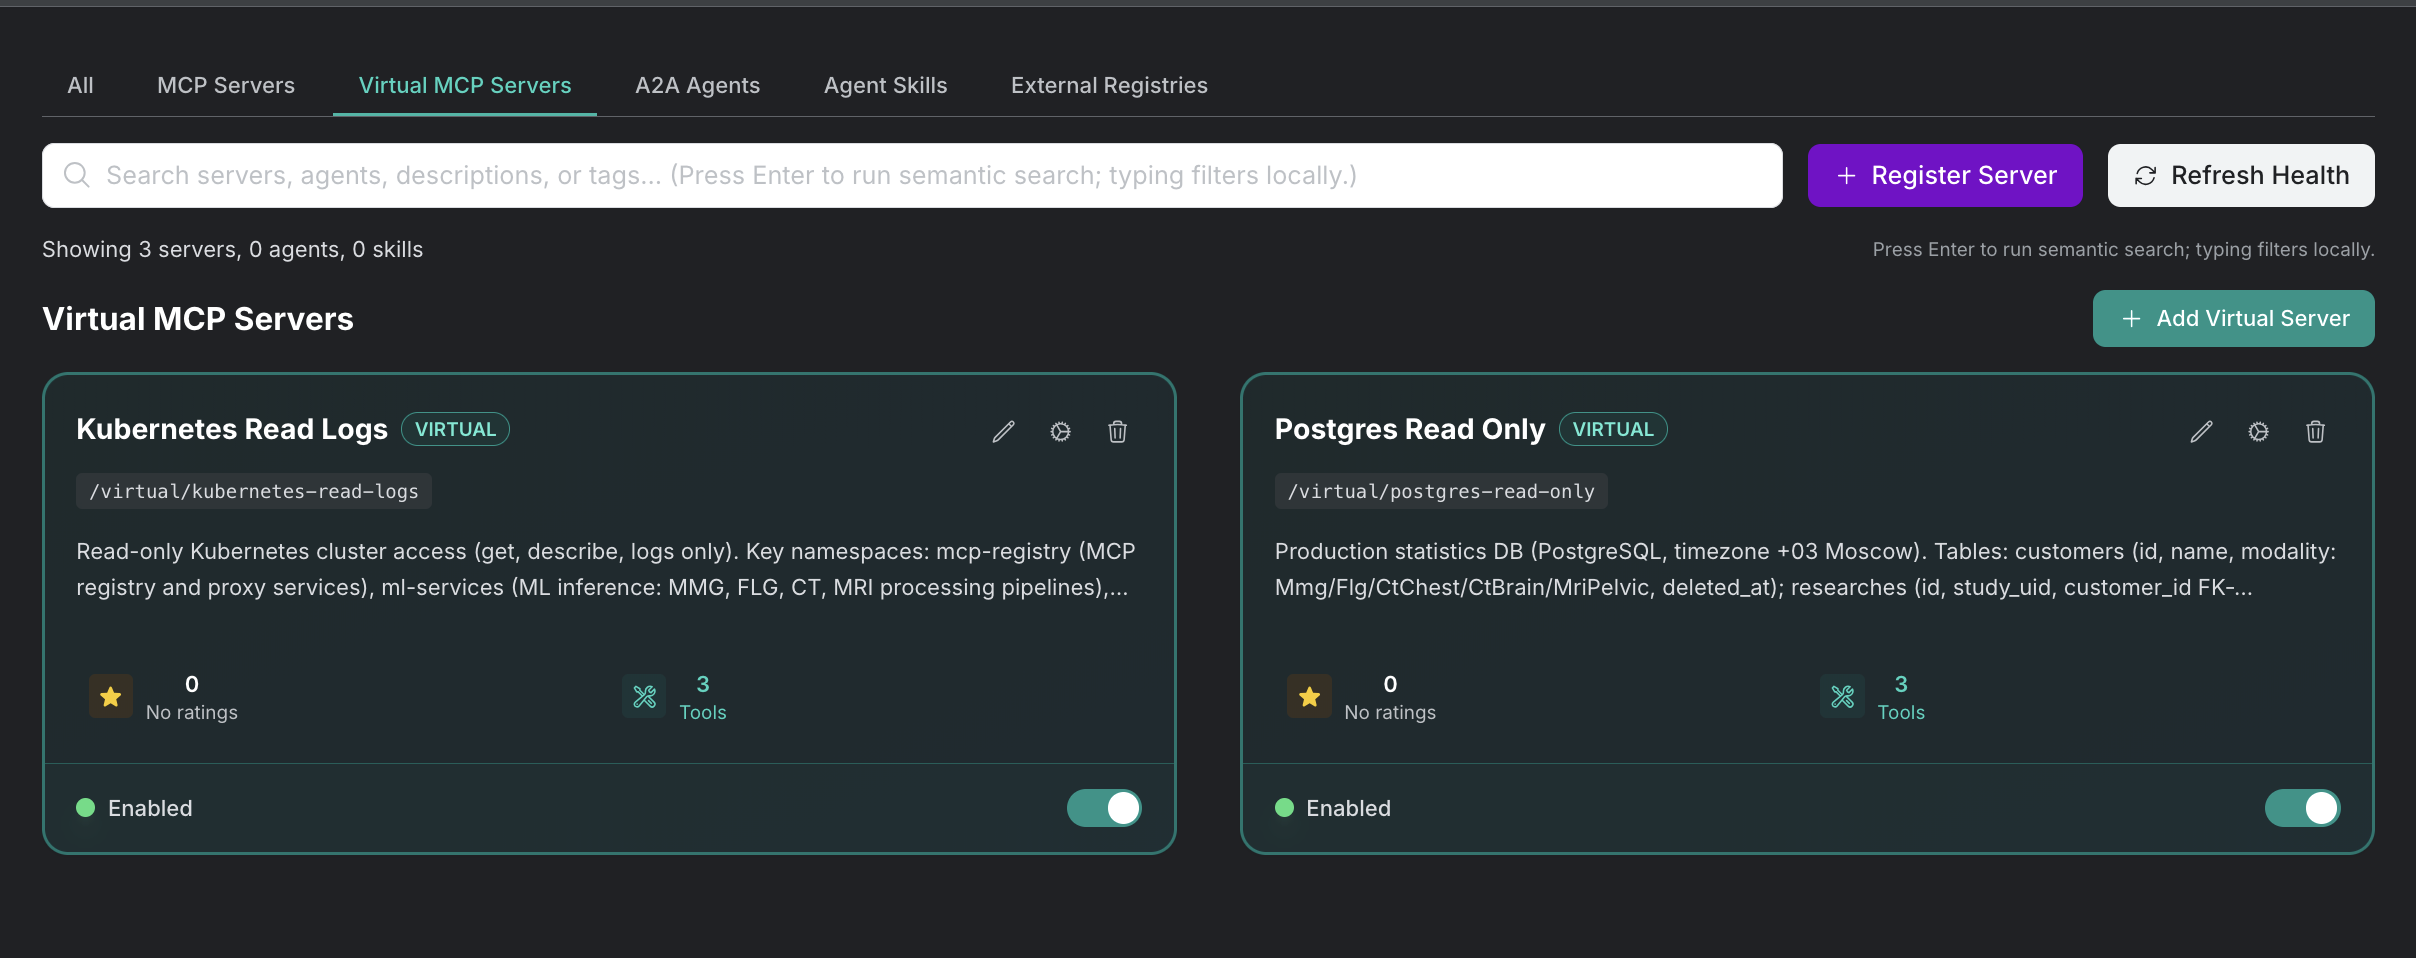
Это позволяет:
- Избежать проблем с настройкой MCP в каждой команде
- Обеспечить безопасный доступ к основным ресурсам
- Позволить ИИ-агентам самим находить нужные MCP
Что мы поняли за время работы с реестром:
- Если схемы тулов подгружаются по требованию, контекст они почти не занимают: 117 тулов у нас - это около 2.3 тысяч токенов. Так что урезать реестр стоит не ради контекста, а ради точности - отобранный набор тулов работает лучше, чем все подряд
- Разным группам людей и агентов удобно делать разные виртуальные сервера со своими наборами инструментов. Но при этом у нас есть и общий рид-онли виртуальный сервер с доступами ко всем основным источникам данных
- MCP хорошо подходит для чтения и точечных запросов, а агрегации лучше делать скриптом. Когда модель сама считает и сортирует сотни строк из ответов MCP, она ошибается. Либо добавляйте в MCP тулы, которые позволяют делать агрегированные запросы
- Claude Code обрезает описание (instructions) MCP-сервера до 4096 символов, так что туда лучше класть короткую карту: с чего начинать и где что лежит. А если нужно добавить к отдельному тулу свой контекст (например, «только наша организация на GitHub»), лучше дописать его к описанию тула, а не заменять описание целиком
- Следите за числом тулов по каждому бэкенду. Сервер может отвечать на ping, но отдавать пустой список тулов, и тогда агент просто видит меньше инструментов. А один зависший бэкенд может положить весь шлюз, так что нужны таймауты и проверка доступности для каждого
- Если шлюз буферизует ответ, долгий вызов тула может оборваться по таймауту простоя, хотя сервер свою работу доделает. Для долгих тулов поднимите
CLAUDE_CODE_MCP_TOOL_IDLE_TIMEOUT - Если ответ тула слишком большой, лучше вернуть ошибку с подсказкой, как сузить запрос, чем молча его обрезать
- Read-only лучше обеспечивать в два слоя: учётка или токен только на чтение плюс явный список разрешённых тулов и запрет опасных. Если у источника нет ключей только на чтение, мы пишем свой небольшой сервер, который вызывает только методы чтения
- Вместо одного общего токена лучше выдавать персональные через SSO. Так видно, кто вызвал тул, и можно отозвать доступ у одного человека, не трогая остальных. Служебным агентам выдаём отдельные ключи
Уровни настройки MCP
Local и user серверы хранятся в ~/.claude.json.
Разница в том, что local-серверы распространяются на конкретный проект, а user - на все проекты.
Project-серверы хранятся в .mcp.json в корне проекта. Этот файл можно закоммитить в репозиторий команды. Таким образом, у всех пользователей будут одинаково настроенные MCP.
Внимание: Лучше не добавлять в этот файл секреты напрямую. По возможности используйте энв-переменные или подобное решение.
Примеры настройки MCP
Notion
Кушает кучу токенов просто на описании инструментов.
"notionApi": {
  "command": "docker",
  "args": [
    "run",
    "--rm",
    "-i",
    "-e",
    "NOTION_TOKEN",
    "mcp/notion"
  ],
  "env": {
    "NOTION_TOKEN": "API_TOKEN"
  }
}
Postgres
MCP для доступа к БД.
"postgresql-mcp-full-statistics": {
  "command": "npx",
  "args": [
    "@henkey/postgres-mcp-server",
    "--connection-string",
    "postgresql://USER:PASSWORD@host:port/postgres"
  ]
}
Целиком файл бы выглядел так с настройкой через энв-переменные:
{
    "mcpServers": {
      "notionApi": {
        "command": "docker",
        "args": [
          "run",
          "--rm",
          "-i",
          "-e",
          "NOTION_TOKEN",
          "mcp/notion"
        ],
        "env": {
          "NOTION_TOKEN": "${NOTION_TOKEN}"
        }
      },
      "postgresql-mcp-full-statistics": {
        "command": "npx",
        "args": [
          "@henkey/postgres-mcp-server",
          "--connection-string",
          "${PG_FULL_STATS_CONNECTION_STRING}"
        ]
      }
    }
  }
Энв-переменные можно положить в свой settings.json в секцию env.
Следующая: Скиллы, плагины, субагенты
Предыдущая: Экономика контекста и prompt caching